Pipeline de automatización con agentes IA
n8n orquesta un agente de IA en Docker; nada se ejecuta sin aprobación humana por chat
Un sistema que corre 24/7 en mi VPS: las solicitudes entran por chat, un agente de IA las analiza dentro de un contenedor y devuelve un resumen con botones. Las tareas largas arrancan solo cuando una persona aprueba.
Sin enlace público: es un sistema privado; se muestra con capturas.
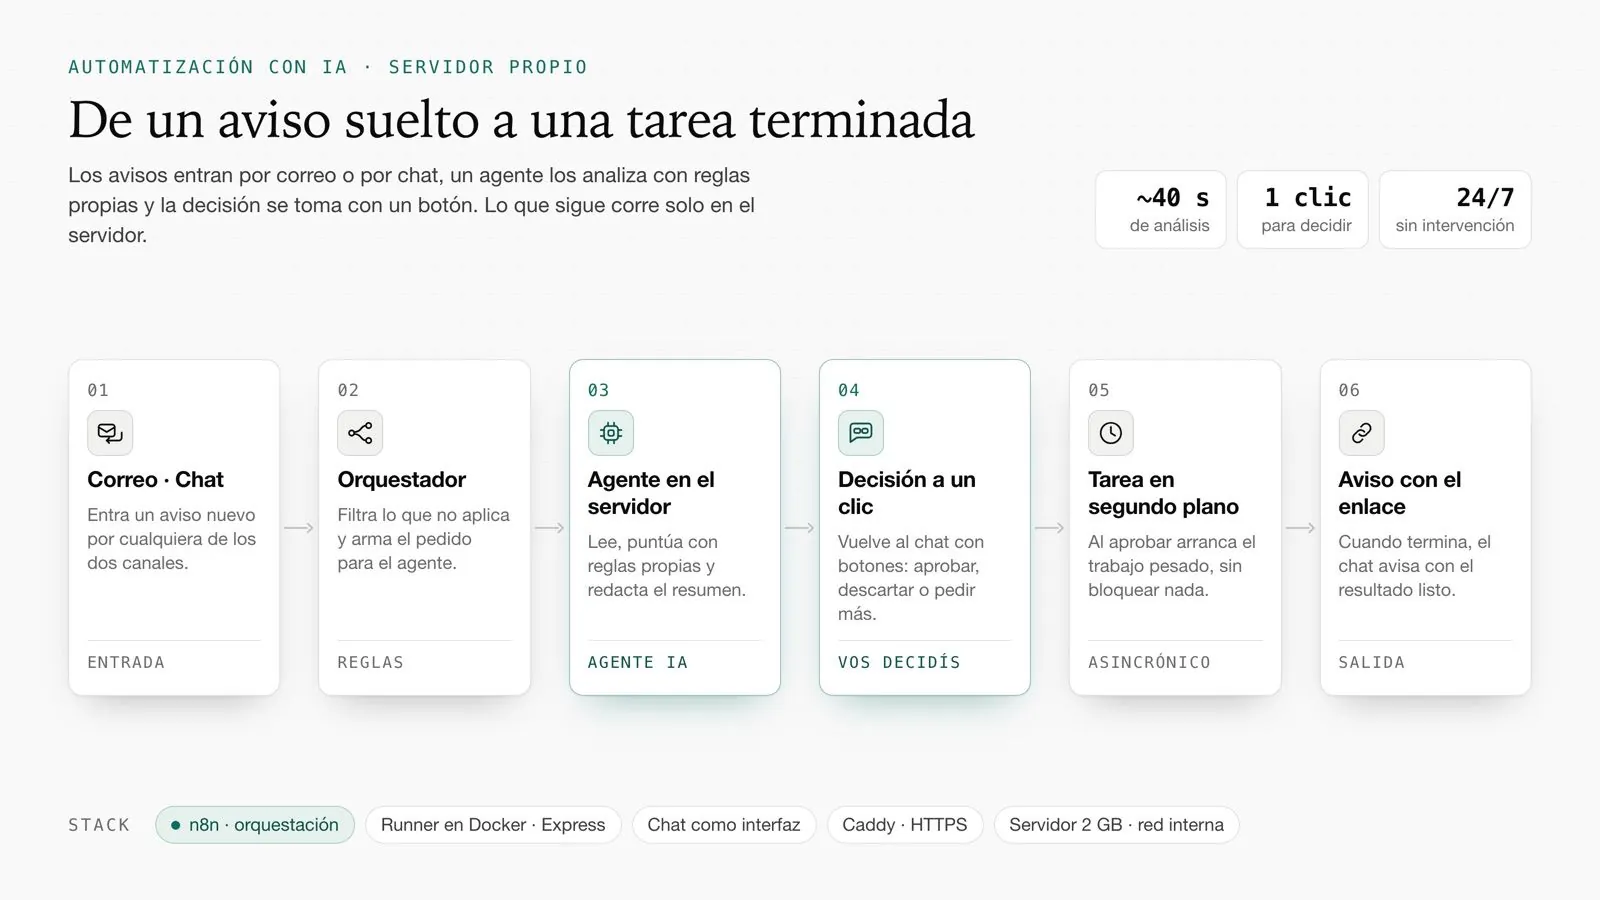
Esquema ilustrativo, datos de ejemplo.
Contexto
Analizar cada solicitud a mano lleva tiempo y el criterio varía según el día. Además, algunas acciones son largas (investigar, construir, desplegar) y no deben salir sin que alguien las revise. Todo tenía que caber en un servidor de 1 vCPU y 2 GB de RAM, donde un agente de IA puede quedarse sin memoria a mitad de trabajo.
Solución
n8n recibe el mensaje y llama a un runner propio (Express) que ejecuta un agente de IA headless dentro de Docker, con las mismas instrucciones y herramientas que uso en local. El resultado vuelve al chat con botones; aprobar encola una tarea larga que avisa con el enlace al terminar.
El runner protege la máquina: un trabajo a la vez, cola persistente, timeouts, vigilante de inactividad y cambio a un modelo más liviano si el sistema lo mata por memoria.
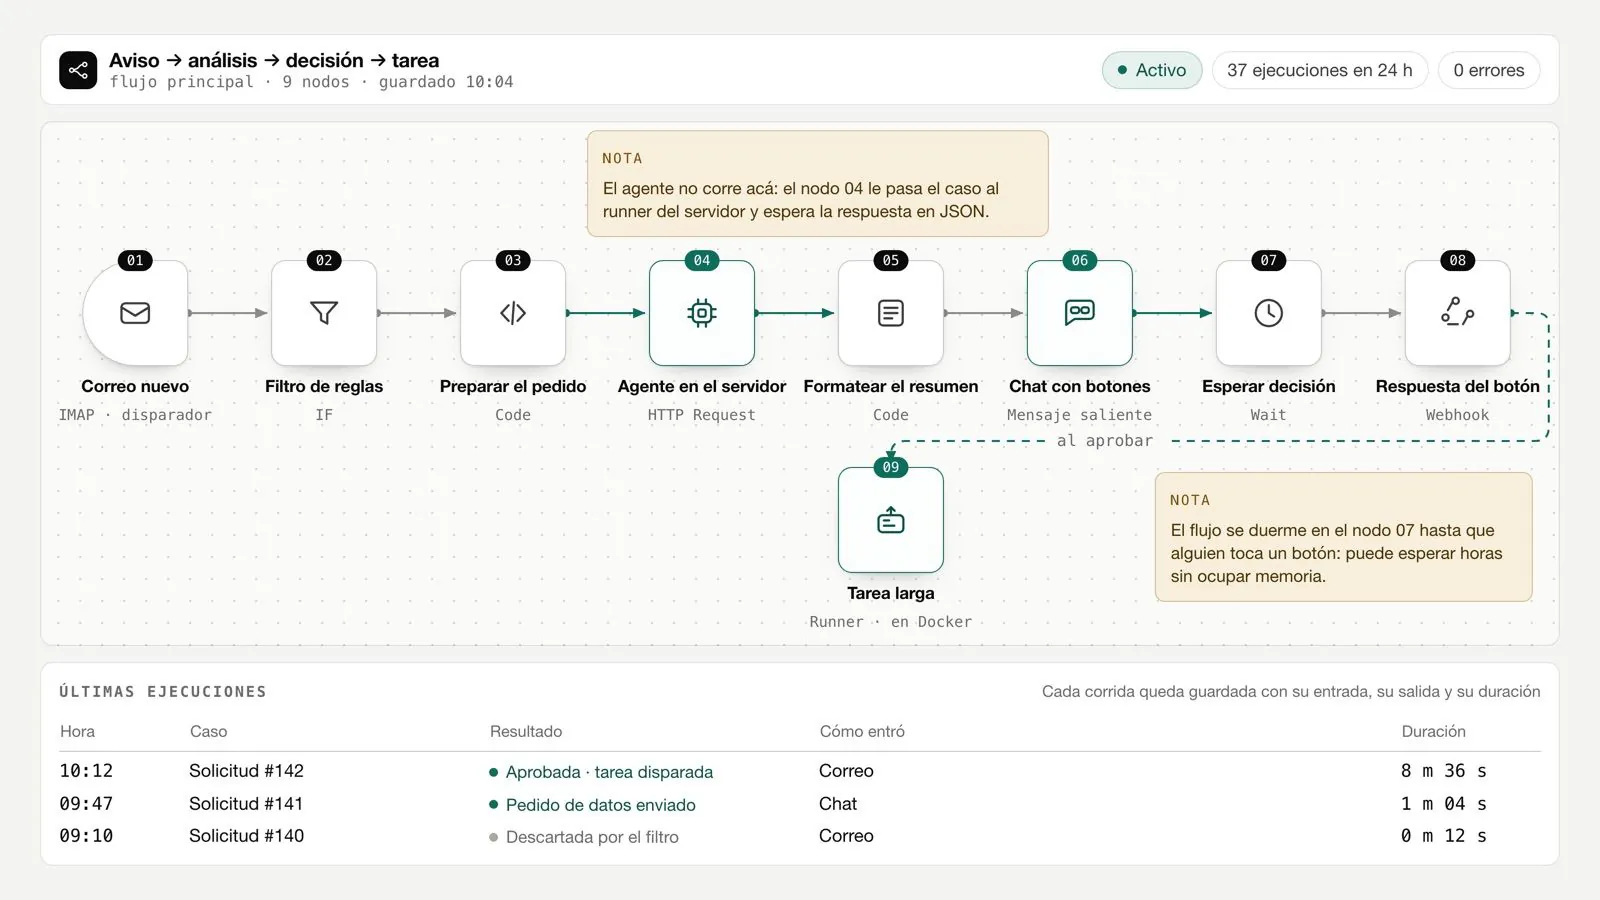
Arquitectura
Llega una solicitud al bot de Telegram
n8n valida el chat y decide la acción
n8n llama al runner por la red interna de Docker, con header secreto
El runner encola y ejecuta el agente de IA con timeout y vigilante de inactividad
El análisis vuelve al chat con botones: aprobar, cambiar o descartar
Al aprobar, la tarea larga se encola en segundo plano (responde 202) y reporta progreso
Al terminar, un webhook validado por header avisa en el chat con el enlace
Piezas
- Bot de Telegram privado: el router descarta en silencio cualquier chat no autorizado
- Caddy: TLS automático, única puerta pública
- n8n: un flujo de 37 nodos (router, switch de acciones, llamadas al runner, respuestas, webhook de cierre)
- Runner Express en Docker, sin puertos publicados; exige un header secreto
- Agente de IA headless + Chromium headless para capturas + documentación oficial vía MCP
- Cola persistida en disco, que sobrevive a reinicios
Decisiones técnicas
Humano en el bucle, siempre
Nada sale ni arranca sin un botón. Por qué: el agente da soporte de decisión, no decide.
Trade-off el sistema no es 100 % autónomo y depende de que alguien responda.
Runner sin puertos públicos
Solo n8n lo alcanza por la red interna de Docker, con header secreto; el webhook de cierre valida el mismo header.
Trade-off para depurar hay que entrar al contenedor.
Un trabajo a la vez, cola persistida
En 2 GB no caben dos agentes; la cola se guarda en disco y las tareas asíncronas se reanudan solas tras un reinicio.
Trade-off cuando hay cola, la espera se nota.
Vigilante de inactividad
Si el agente no emite ningún evento en 8 minutos, se corta. Nació de tres trabajos que murieron a los 25 minutos esperando un Chromium colgado: el peor caso bajó a unos 8.
Trade-off una tarea legítima que pase más de 8 minutos en silencio también se corta.
Cambio de modelo ante falta de memoria
Si el sistema mata al agente sin error (señal típica del OOM killer en 2 GB), se reintenta con un modelo más liviano, retomando el trabajo parcial.
Trade-off ese caso sale con un modelo de menor capacidad.
Resultados
- Corre 24/7 en un VPS de 1 vCPU y 2 GB
- Peor caso de un trabajo colgado: de 25 a ~8 minutos
- Logs rotados (10 MB × 3) e historial de n8n acotado a 7 días / 5000 ejecuciones
- Recuperado el mismo día tras el incidente del 8-sep, con su base intacta
Stack
- n8n
- Node.js 22 + Express
- Docker Compose
- Caddy
- agente de IA headless (Claude Code)
- Chromium headless
- Telegram Bot API
- GitHub CLI
- Vercel CLI